第 9 章 在一起更好还是分开更好?
软件设计中最基本的问题之一是:两个功能应该放在同一个地方实现,还是分开实现?这个问题适用于系统中的所有层级,例如函数、方法、类和服务。例如,缓冲应该由提供面向流的文件 I/O 的类实现,还是由单独的类实现?HTTP 请求的解析应该全部放在一个方法中,还是分散到多个方法(甚至多个类)中?本章讨论做出这些决定时需要考虑的因素。其中一些因素在前面已经讨论过,但为了完整起见,这里会再次介绍。
本章概览两个功能放在一起实现,还是分开实现?

决定组合还是分开时,目标是降低整个系统的复杂性,并改善模块化程度。将系统划分为大量小组件,看起来可能是实现这一目标的最佳方法:组件越小,每个组件可能就越简单。但是,细分本身也会引入原本不存在的复杂性:
- 一部分复杂性仅仅来自组件的数量:组件越多,就越难掌握所有组件,也越难从中找到所需的组件。细分通常会带来更多接口,而每个新接口都会增加复杂性。
- 细分可能需要额外的代码来管理组件。例如,一段原本只使用单个对象的代码,细分后可能必须管理多个对象。
- 细分会使组件分散开来:细分后的组件比原来离得更远。例如,原本位于同一个类中的方法,细分后可能位于不同的类中,甚至不同的文件中。这样一来,开发人员更难同时查看这些组件,甚至可能不知道某些组件的存在。如果组件真正独立,分开是有益的:开发人员可以一次专注于一个组件,不受其他组件干扰。反之,如果组件之间存在依赖关系,分开就不利了:开发人员不得不在组件之间来回跳转。更糟糕的是,他们可能没有意识到这些依赖关系,从而引入代码缺陷。
- 细分可能导致重复:原本只出现一处的代码,可能需要在细分后的每个组件中各放一份。
代码段紧密相关时,将它们组合在一起最有益。如果彼此无关,分开可能更好。以下迹象可以帮助判断两个代码段是否相关:
- 它们共享信息。例如,两段代码都可能依赖某一类文档的语法。
- 它们会一起使用:使用其中一段代码的人很可能也会使用另一段。这种关系只有在双向成立时,才足以支持将两者组合起来。反例是磁盘块高速缓存:它几乎总会用到哈希表,但哈希表还可用于许多不涉及磁盘块高速缓存的场景。因此,这些模块应该分开。
- 它们在概念上有所重叠,可以归入一个简单的、更高层级的类别。例如,搜索子字符串和大小写转换都属于字符串操作,而流量控制和可靠传输都属于网络通信。
- 不看其中的一段代码就很难理解另一段。
本章其余部分将通过更具体的规则和示例,说明何时应该组合代码段,何时应该将它们分开。
9.1 如果有信息共享则组合到一起
第 5.4 节通过实现 HTTP 服务器的项目介绍了这一原则。在最初的实现中,该项目用分属两个类的方法来读取和解析 HTTP 请求。第一个方法从网络套接字读取传入请求的文本,并将其放入字符串对象中。第二个方法解析字符串,提取请求的各个组成部分。这样分解后,两个方法都需要了解不少 HTTP 请求的格式信息:第一个方法虽然只想读取请求,而不想解析请求,但如果不完成大部分解析工作,就无法确定请求的结束位置(例如,它必须解析标头行,才能识别包含整个请求长度的标头)。由于两者共享这些信息,最好在同一处读取和解析请求。将两个类合为一个后,代码变得更短、更简单。
9.2 如果可以简化接口则组合到一起
将两个或多个模块组合成一个模块时,就有可能为新模块定义比原有接口更简单或更易用的接口。如果原有模块各自只实现解决方案的一部分,通常就有这样的机会。在上一节的 HTTP 服务器示例中,原来的方法需要通过接口,由第一个方法返回 HTTP 请求字符串,再传给第二个方法。将这些方法组合在一起后,就不再需要这些接口。
另外,将两个或更多类的功能组合在一起后,某些功能就可能自动执行,让大多数用户无需了解它们。Java I/O 库就有这样的机会:如果将 FileInputStream 和 BufferedInputStream 类组合起来,默认提供缓冲,绝大多数用户甚至不必知道缓冲的存在。组合后的 FileInputStream 类可以提供禁用或替换默认缓冲机制的方法,但大多数用户不需要了解这些方法。
9.3 通过组合来消除重复
如果发现反复出现的代码模式,请考虑能否重新组织代码以消除重复。一种做法是将重复代码提取为单独的方法,再用方法调用替换重复的代码段。如果重复代码较长,而提取出的方法签名简单,这种做法最有效。如果代码段只有一两行,替换成方法调用可能没有太大好处。如果代码段与周围代码的交互很复杂(例如,需要访问多个局部变量),提取出的方法可能也需要复杂的签名(例如,许多“按引用传递”的参数),这就降低了提取方法的价值。
消除重复的另一种做法是重构代码,让相关代码段只需在一处执行。假设你正在编写一个方法,需要在几个不同的位置返回错误,并且每次返回前都要执行相同的清理操作(示例请参见图 9.1)。如果编程语言支持 goto,就可以将清理代码移到方法末尾,在每个需要返回错误的位置跳转到那里,如图 9.2 所示。Goto 语句通常不受推崇,滥用确实可能使代码难以维护;但在这类情况下,它们可以帮助跳出嵌套代码,因此也有用处。
switch (common->opcode) {
    case DATA: {
        DataHeader* header = received->getStart<DataHeader>();
        if (header == NULL) {
            LOG(WARNING, "%s packet from %s too short (%u bytes)",
                    opcodeSymbol(common->opcode),
                    received->sender->toString(),
                    received->len);
            return;
        }
        ...
    case GRANT: {
        GrantHeader* header = received->getStart<GrantHeader>();
        if (header == NULL) {
            LOG(WARNING, "%s packet from %s too short (%u bytes)",
                    opcodeSymbol(common->opcode),
                    received->sender->toString(),
                    received->len);
            return;
        }
        ...
    case RESEND: {
        ResendHeader* header = received->getStart<ResendHeader>();
        if (header == NULL) {
            LOG(WARNING, "%s packet from %s too short (%u bytes)",
                    opcodeSymbol(common->opcode),
                    received->sender->toString(),
                    received->len);
            return;
        }
        ...
}
图 9.1:此代码处理不同类型的传入网络数据包。如果数据包的长度不足以满足所属类型的要求,就会记录一条消息。在此版本的代码中,针对几种不同的数据包类型,重复写了相同的 LOG 语句。
switch (common->opcode) {
    case DATA: {
        DataHeader* header = received->getStart<DataHeader>();
        if (header == NULL)
            goto packetTooShort;
        ...
    case GRANT: {
        GrantHeader* header = received->getStart<GrantHeader>();
        if (header == NULL)
            goto packetTooShort;
        ...
    case RESEND: {
        ResendHeader* header = received->getStart<ResendHeader>();
        if (header == NULL)
            goto packetTooShort;
        ...
}
...
packetTooShort:
LOG(WARNING, "%s packet from %s too short (%u bytes)",
        opcodeSymbol(common->opcode),
        received->sender->toString(),
        received->len);
return;
图 9.2:重新组织图 9.1 中的代码后,LOG 语句只需保留一份。
9.4 分离通用代码和专用代码
如果一个模块包含可用于多种用途的机制,就应只提供这一通用机制。它不应包含针对某种特定用途定制该机制的代码,也不应包含其他通用机制。与通用机制相关的专用代码,通常应放在另一个模块中,往往就是负责该特定用途的模块。第 6 章对图形界面编辑器的讨论阐明了这一原则:最佳设计是让文本类提供通用文本操作,而将特定于用户界面的操作(例如删除所选区域)放在用户界面模块中实现。早期设计将专用的用户界面操作放在文本类中实现,产生了信息泄露和额外接口;新设计消除了这些问题。
 危险信号:重复

如果相同的代码(或几乎相同的代码)一遍又一遍地出现,那是一个危险信号,说明你没有找到正确的抽象。
9.5 示例:插入光标和区域选择
接下来的小节将通过两个示例说明上述原则。在第一个示例中,最好将相关代码段分开;在第二个示例中,最好将它们组合在一起。
第一个示例来自第 6 章的图形界面编辑器项目,涉及插入光标和所选区域。编辑器用一条闪烁的竖线表示用户键入的文本将出现在文档中的位置。它还会高亮显示一段字符,称为所选区域,用于复制或删除文本。插入光标始终可见,但有时并没有选中文本。如果存在所选区域,插入光标始终位于其某一端。
所选区域和插入光标在某些方面是相关的。例如,光标始终位于所选区域的一端,而且两者通常一起操作:单击并拖动鼠标会同时修改两者;插入文本时,则先删除所选文本(如果有),再在光标位置插入新文本。因此,用单个对象管理所选区域和插入光标似乎合乎逻辑,有一个项目团队就采用了这种做法。该对象保存了文件中的两个位置,以及两个布尔值,分别表示光标位于所选区域的哪一端,以及是否存在所选区域。
但是,组合后的对象并不好用。它没有为更高层级的代码带来任何好处,因为这些代码仍需将所选区域和插入光标视为不同的实体,分别操作(插入文本时,先调用组合对象的一个方法来删除所选文本,再调用另一个方法获取光标位置,以便插入新文本)。实际上,组合对象的实现比分开的对象复杂得多。它虽然不必单独存储光标位置,却不得不存储一个布尔值,表示光标位于所选区域的哪一端。获取光标位置时,组合对象必须先检查布尔值,再读取所选区域相应的起始或结束位置。
在这种情况下,所选区域和插入光标的关联还不足以支持将它们组合起来。修改代码,将两者分开后,使用和实现都变得更简单。相比需要从中提取所选区域和插入光标信息的组合对象,分开的对象提供了更简单的接口。插入光标的实现也更简单,因为其位置可以直接表示,不必通过所选区域和一个布尔值间接表示。实际上,修订后的版本没有为所选区域或插入光标设置专用类,而是引入了一个新的 Position 类,表示文件中的位置(行号和字符在行内的位置)。所选区域用两个 Position 表示,光标用一个 Position 表示。Position 类在项目中还有其他用途。这个例子也展示了第 6 章讨论过的更低层级但更通用的接口的好处。
危险信号:通用专用混合体
当通用机制中包含针对某种特定用途定制的代码时,就会出现这一危险信号。这会使机制更复杂,并在机制与特定用例之间造成信息泄露:将来修改用例时,很可能也必须修改底层机制。
译者图解合并对象为何反而增加一次判断?

9.6 示例:单独的日志记录类
第二个示例涉及一个学生项目中的错误日志记录。有一个类中包含几个如下所示的代码序列:
try {
    rpcConn = connectionPool.getConnection(dest);
} catch (IOException e) {
    NetworkErrorLogger.logRpcOpenError(req, dest, e);
    return null;
}
这段代码没有在检测到错误时直接记录日志,而是调用专用错误日志记录类中的方法。这个类定义在同一源文件的末尾:
private static class NetworkErrorLogger {
    /**
    *  Output information relevant to an error that occurs when trying
    *  to open a connection to send an RPC.
    *
    *  @param req
    *       The RPC request that would have been sent through the connection
    *  @param dest
    *       The destination of the RPC
    *  @param e
    *       The caught error
    */
    public static void logRpcOpenError(RpcRequest req, AddrPortTuple dest, Exception e) {
        logger.log(Level.WARNING, "Cannot send message: " + req + ". \n" +
            "Unable to find or open connection to " + dest + " :" + e);
    }
...
}
NetworkErrorLogger 类包含几个方法,例如 logRpcSendError 和 logRpcReceiveError,每个方法都记录了不同类型的错误。
这种分离除了增加复杂性,没有任何好处。日志记录方法很浅:大多数只有一行代码,却需要大量文档。每个方法都只在一处调用,并且高度依赖调用方:阅读调用方代码的人,很可能需要跳到日志记录方法,确认记录的信息是否正确;阅读日志记录方法的人,也很可能需要跳回调用方,才能理解该方法的用途。
在此示例中,最好移除日志记录方法,将日志记录语句放在检测到错误的位置。这样既让代码更易读,也消除了日志记录方法所需的接口。
译者图解这条日志为什么不需要一个专用包装类?

9.7 拆分和组合方法
何时细分的问题不仅适用于类,也适用于方法:应该将现有方法拆成多个较小的方法,还是将两个较小的方法组合成一个较大的方法?长方法往往比短方法更难理解,因此许多人认为,方法较长就是拆分它的充分理由。课堂上,学生常被要求遵守严格的标准,例如“拆分所有超过 20 行的方法!”
但是,仅凭长度很少足以构成拆分方法的理由。开发人员往往过于倾向拆分方法。拆分会引入额外接口,增加复杂性,也会将原方法的各个部分分散开来。如果这些部分实际上相互关联,代码反而会更难阅读。只有当拆分能使整个系统更简单时,才应该拆分方法,下面将讨论这样的情况。
长方法并不总是不好。例如,假设一个方法包含五个按顺序执行、各有 20 行的代码块。如果这些代码块相对独立,读者可以逐块阅读和理解,将每块移到单独的方法中并没有太大好处。如果代码块之间存在复杂交互,将它们放在一起就更重要了,这样读者才能一次看到所有相关代码。若每块都放在单独的方法中,读者就不得不来回切换,才能理解它们如何协同工作。只要方法的签名简单、代码易读,即使有数百行也可以接受。这样的方法很深,功能多而接口简单,是好的方法。
设计方法时,最重要的目标是提供整洁的抽象。每个方法都应该做一件事,并将这件事完整地做好。接口应该简单,让用户不必掌握太多信息就能正确使用。方法还应该是深的:接口应远比实现简单。如果一个方法具备所有这些特性,长短可能就不重要了。
总体而言,只有能产生更清晰的抽象,拆分方法才有意义。如图 9.3 所示,有两种拆分方式。最佳做法是将子任务提取为单独的方法,如图 9.3(b)所示。这样会得到一个负责子任务的子方法,以及一个包含原方法其余部分的父方法,由父方法调用子方法。新父方法的接口与原方法相同。如果某个子任务能与原方法的其余部分完全分离,这种拆分就有意义:阅读子方法的人不必了解父方法,阅读父方法的人也不必了解子方法的实现。通常,这意味着子方法相对通用,可以设想其他方法也会使用它。如果拆分后仍需在父方法和子方法之间来回跳转,才能理解它们如何协同工作,就是一个危险信号(“连体方法”),说明拆分可能并不合适。
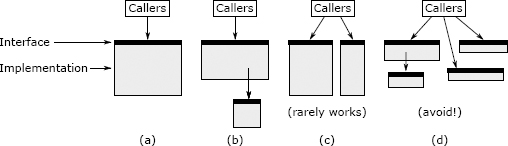
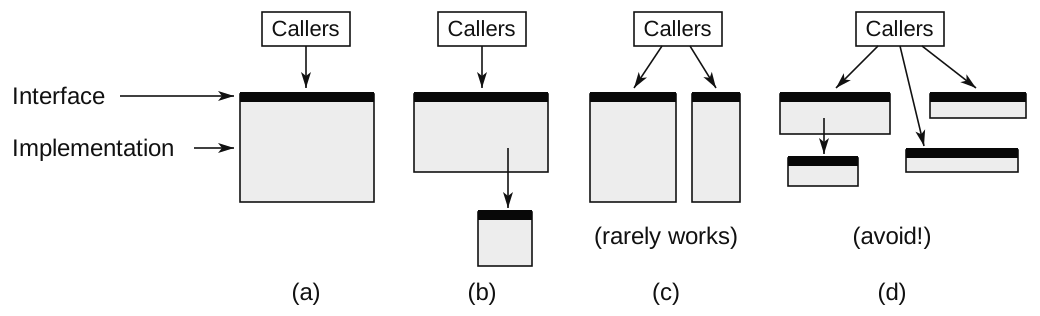
图 9.3:方法(a)可以通过提取子任务(b)或将其功能划分为两个单独的方法(c)进行拆分。但如果会导致浅方法,则不应进行方法拆分,如(d)所示。
第二种方式是将方法拆成两个独立的方法,两者都对原方法的调用者可见,如图 9.3(c)所示。如果原方法试图执行多个并不密切相关的操作,导致接口过于复杂,这样拆分就有意义。可以将原方法的功能分到两个或更多较小的方法中,每个方法只承担其中一部分。拆分后,每个子方法的接口都应比原接口更简单。理想情况下,大多数调用者只需调用两个新方法中的一个;如果必须同时调用两者,就会增加复杂性,这可能说明拆分并不合适。新方法的职责会更集中。如果它们比原方法更通用,例如可以在其他场景中单独使用,也是一个好兆头。
图 9.3(c)这种拆分并不常适用,因为调用者要面对的不再是一个方法,而是多个方法。这样拆分还有可能产生多个浅方法,如图 9.3(d)所示。如果调用者必须逐一调用这些方法,并在它们之间来回传递状态,拆分就不是好主意。考虑图 9.3(c)这样的拆分时,应以它是否让调用者更容易使用为判断依据。
在某些情况下,将方法组合起来可以简化系统。例如,可以用一个更深的方法代替两个浅方法;可以消除重复代码;可以消除原方法之间的依赖关系,或省去中间数据结构;可以改善封装,将原本分散在多处的知识集中到一处;还可以简化接口,如 9.2 节所述。
危险信号:连体方法
每个方法都应该能独立理解。如果必须先理解一个方法的实现,才能理解另一个方法的实现,就是一个危险信号。这也适用于其他情况:两段代码虽然分开存放,却必须结合另一段才能理解,就是危险信号。
9.8 不同的观点:《代码整洁之道》
在《代码整洁之道》一书中 [1],Robert Martin 认为,仅凭长度就应该拆分函数。他说,函数应该非常短,甚至 10 行都太长了:
函数的第一条规则是要短小,第二条规则是还要更短小……if 语句、else 语句、while 等语句块中的代码应该只有一行,而这一行很可能是一个函数调用……这也意味着函数不应该大到足以容纳嵌套结构。因此,函数的缩进层级不应超过一层或两层。这当然会让函数更容易阅读和理解。
我同意,短函数通常比长函数更容易理解。然而,函数缩短到几十行后,继续减少行数不太可能明显改善可读性。更重要的问题是:拆分函数是否降低了系统的整体复杂性?换句话说,阅读几个短函数并理解它们如何协同工作,是否比阅读一个较大的函数更容易?函数越多,需要编写文档和学习的接口也越多。如果函数过小,就会失去独立性,成为必须一起阅读和理解的连体函数。这时最好保留较大的函数,让所有相关代码留在一处。深度比长度更重要:先让函数足够深,再尽量缩短到易于阅读的程度。不要为了长度牺牲深度。
9.9 结论
拆分或组合模块的决定应基于复杂性。请选择一种可以提供最好的信息隐藏、最少的依赖关系和最深的接口的结构。
[1] 代码整洁之道,Robert C. Martin, Pearson Education, Inc., Boston, MA 2009 ↩
本章回顾从“越小越简单”的直觉,到按复杂性决定组合还是分开
