第 20 章 性能设计
到目前为止,关于软件设计的讨论都围绕复杂性展开,目标是使软件尽可能简单易懂。但如果你正在开发的系统需要运行得很快,该怎么办?性能方面的考虑应如何影响设计过程?本章讨论如何在保持设计整洁的同时实现高性能。最重要的仍然是简单:简单不仅能改善系统设计,通常也能让系统运行得更快。
本章概览追求高性能,设计还能保持整洁吗?

20.1 如何考虑性能
要解决的第一个问题是:“在正常开发过程中,应该在多大程度上关注性能?”如果试图优化每条语句以追求最快的运行速度,就会拖慢开发,并引入大量不必要的复杂性。此外,许多“优化”实际上并不能改善性能。另一方面,如果完全忽略性能问题,低效的设计和实现就容易遍布代码,最终系统的运行耗时很容易达到本来所需时间的 5–10 倍。到了这一步,再回头改进性能也很困难,因为任何一处改进都难以产生显著效果。
最好的做法介于这两个极端之间:利用有关性能的基本知识,选择“自然高效”而又整洁、简单的设计方案。关键是了解哪些操作本身开销就很大。以下是一些如今仍然开销较大的操作:
- 网络通信:即使在数据中心内,一次消息往返也可能需要 10 到 50 微秒,相当于执行数万条指令的时间。而广域网的消息往返可能需要 10 到 100 毫秒。
- 辅助存储的 I/O:磁盘的 I/O 操作通常需要 5 到 10 毫秒,相当于执行数百万条指令的时间。闪存存储需要 10 到 100 微秒。新出现的非易失性存储器耗时可能短至 1 微秒,但这仍然相当于执行大约 2000 条指令的时间。
- 动态内存分配(C 语言中的
malloc,C++ 或 Java 中的new)通常涉及分配、释放和垃圾回收方面的大量开销。 - 缓存缺失:将数据从内存提取到处理器片上的高速缓存中需要数百条指令的执行时间;在许多程序中,整体性能受缓存缺失的影响程度与受计算开销的影响程度一样大。
了解哪些操作开销较大的最好方法,是运行微基准测试,即单独衡量某个操作开销的小程序。在 RAMCloud 项目中,我们编写了一个简单程序,提供微基准测试框架。创建框架花了几天时间,但有了它,添加新的微基准测试只需五到十分钟。这样,我们积累了几十个微基准测试,既可以用来了解 RAMCloud 所用现有库的性能,也可以衡量为 RAMCloud 编写的新类的性能。
大致了解哪些操作开销大、哪些开销小之后,就可以据此尽量选择开销小的操作。在许多情况下,高效的方法与较慢的方法同样简单。例如,需要存储大量按键查找的对象时,可以使用哈希表或有序映射(ordered map)。库中通常会提供这两种结构,而且都简单易用。不过,哈希表的速度很容易达到有序映射的 5 到 10 倍。因此,除非需要映射(map)的有序性,否则应使用哈希表。
再看一个例子:在 C 或 C++ 之类的语言中为结构数组分配内存。有两种做法。一种是让数组存储指向结构的指针,这样就必须先为数组分配空间,再为每个结构单独分配空间。另一种是将结构直接存储在数组中,只需为所有内容分配一大块内存,效率要高得多。
如果提高效率的唯一办法是增加复杂性,选择就更困难了。如果更高效的设计只增加少量复杂性,而且这些复杂性隐藏在内部,不影响任何接口,那么这样做可能是值得的(但要注意:复杂性会逐渐累积)。如果更快的设计大幅增加了实现的复杂性,或使接口更复杂,那么最好先采用更简单的方法,等性能成为问题时再优化。不过,如果有明确证据表明性能在当前情况下很重要,也可以立即实现更高效的方法。
在 RAMCloud 项目中,我们的总体目标之一,是让客户端机器通过数据中心网络访问存储系统时的延迟尽可能低。因此,我们决定使用特殊的网络硬件,让 RAMCloud 绕过内核,直接通过网络接口控制器收发数据包。尽管这增加了复杂性,我们还是做出了这个决定,因为先前的测量表明,基于内核的网络通信太慢,无法满足需求。在 RAMCloud 系统的其余部分,大多数地方都能保持设计简单。把这个大问题“解决好”,其他事情就会容易得多。
一般来说,简单的代码往往比复杂的代码运行得更快。如果已经通过定义规避了特殊情况和异常情况,就不再需要检查这些情况的代码,系统也会运行得更快。深类比浅类更高效,因为每次方法调用都能完成更多工作。浅类会导致更多跨层级操作,而每次跨越层级都会增加运行开销。
20.2 修改前(和修改后)的测量
但假设你已经按上述方式设计了系统,它仍然太慢。这时很容易凭直觉猜测性能问题的原因,并匆忙调整代码。不要这样做!程序员对性能的直觉并不可靠,即使是经验丰富的开发人员也不例外。如果凭直觉修改,你会把时间浪费在无法提高性能的事情上,还可能在这个过程中使系统变得更复杂。
进行任何修改之前,请先测量系统当前的运行表现。这有两个目的。首先,找出性能调整最能产生效果的地方。仅测量系统整体性能是不够的:它可能说明系统太慢,却不能说明原因。你需要更深入地测量,查清影响整体性能的具体因素。目标是找出少数具体位置:它们目前耗费大量时间,而你也有改进的思路。第二个目的是建立基线,以便修改后再次测量,确认性能确实得到改善。如果测不出性能差异,就撤销这些修改(除非它们使系统更简单)。除非能显著提高速度,否则保留额外复杂性就没有意义。
译者图解优化需要两种测量证据

20.3 围绕关键路径进行设计
现在假设你已经仔细分析性能,找到了一段运行缓慢、足以影响整个系统性能的代码。改善其性能的最佳方法是进行“根本性的”修改,例如引入缓存,或更换算法(例如在平衡树和列表之间选择)。我们让 RAMCloud 的网络通信绕过内核,就是一个根本性改进的例子。如果找到了这样的改进方案,就可以用前面各章讨论的设计技术来实现它。
不幸的是,有时找不到根本性的解决办法。这就引出了本章的核心问题:如何重新设计现有代码,使其运行得更快。这应当是最后的手段,不应经常采用,但在某些情况下可能带来显著改善。关键思想是围绕关键路径设计代码。
首先问自己:在常见情况下,完成所需任务最少要执行多少代码?暂时不考虑现有代码结构,设想自己正在编写一个只实现关键路径的新方法,其中只包含最常见情况下必须执行的最少代码。现有代码可能充满特殊情况,但在这个练习中,请先忽略它们。关键路径上可能有多个方法调用,不妨设想把所有相关代码放进一个方法。现有代码也可能使用各种变量和数据结构;这里只考虑关键路径所需的数据,并设想最适合关键路径的数据结构。例如,将多个变量合并为一个值可能是合理的。假设你可以彻底重新设计系统,尽量减少执行关键路径所需的代码。我们把这段代码称为“理想的代码”。
理想的代码可能与现有的类结构冲突,也可能不切实际,但它提供了一个很好的目标:尽可能简单、快速的代码。下一步是寻找一种新设计,在保持结构整洁的同时尽量接近这个目标。可以应用前面各章中的所有设计思想,但要尽量保持理想代码的完整性。为了形成整洁的抽象,可能需要在理想代码上添加少量代码。例如,如果涉及哈希表查找,多调用一次通用哈希表类的方法是可以接受的。根据我的经验,几乎总能找到既简洁明了、又非常接近理想状态的设计。
在这个过程中,最重要的事情之一是从关键路径中移除特殊情况。代码运行缓慢,通常是因为它必须处理多种情况,而其结构又是为了方便处理所有这些情况而设计的。每个特殊情况都会以额外的条件语句、方法调用或两者兼有的形式,在关键路径上添加代码。每增加一处,代码就慢一些。为提高性能而重新设计时,应尽量减少需要检查的特殊情况。理想情况下,开头有一个 if 语句,一次检查就能识别所有特殊情况。正常情况下,只做这一次检查,之后便可执行关键路径,不必再检查其他特殊情况。如果初始检查未通过(意味着出现了特殊情况),就转到关键路径之外的分支处理。特殊情况下性能没那么重要,因此可以优先让处理代码保持简单,不必过于追求性能。
译者图解让特殊情况离开常见路径

20.4 示例:RAMCloud 缓冲区
来看一个例子:我们优化了 RAMCloud 存储系统的 Buffer 类,使最常见操作的性能达到原来的约两倍。
RAMCloud 使用 Buffer 对象管理可变长度的内存数组,例如远程过程调用的请求和响应消息。Buffer 的设计旨在减少内存复制和动态存储分配的开销。Buffer 中看上去存储的是一个线性的字节数组,但为了提高效率,它允许底层存储将其划分为多个不连续的内存块,如图 20.1 所示。Buffer 是通过追加数据块创建的。每个块要么是外部的,要么是内部的。如果块是外部的,则其存储空间由调用方拥有,Buffer 中保存对此存储的引用。外部块通常用于大型块,以避免内存复制。如果块是内部的,则 Buffer 拥有该块的存储,调用者提供的数据将被复制到 Buffer 的内部存储中。
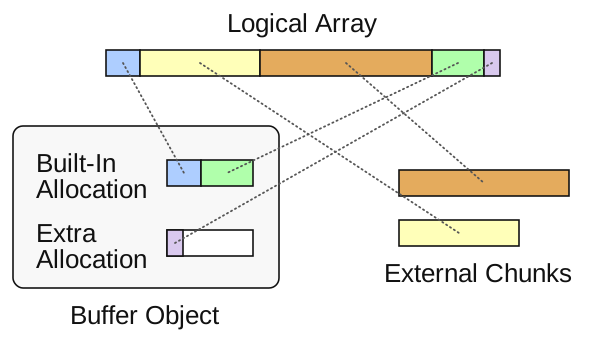
图 20.1:Buffer 对象用一组内存块存储线性字节数组。内部块由 Buffer 拥有,在 Buffer 销毁时释放;外部块不属于 Buffer。
每个 Buffer 都内置一小块内存区域,用于存储内部块。如果这部分空间用尽,Buffer 就会分配额外的内存区域,并在 Buffer 销毁时释放它们。内部块适合存放少量数据,因为此时内存复制的开销可以忽略不计。图 20.1 显示了一个具有 5 个块的 Buffer:第一个块是内部的,接下来的两个块是外部的,最后两个块是内部的。
Buffer 类本身就是一种“根本性的改进”,因为它避免了原本必需的高开销内存复制。例如,在 RAMCloud 存储系统中组装包含短标头和较大对象内容的响应消息时,RAMCloud 使用带有两个块的 Buffer。第一个是包含标头的内部块;第二个是外部块,引用 RAMCloud 存储系统中的对象内容。这样就能在不复制大对象的情况下,将响应组装到 Buffer 中。
除了允许使用不连续块这一基本设计外,最初实现时,我们并没有尝试优化 Buffer 类的代码。但随着时间推移,我们发现 Buffer 的使用越来越频繁。例如,每次远程过程调用期间,至少会创建四个 Buffer 对象。后来,我们意识到优化 Buffer 的实现可能显著改善系统整体性能,于是决定看看能否提高 Buffer 类的性能。
Buffer 最常见的操作是使用内部块为少量新数据分配空间,例如为请求和响应消息创建标头时。我们决定将这一操作作为优化的关键路径。在最简单的情况下,可以通过扩大 Buffer 中最后一个现有块来分配空间。但只有当最后一个块是内部块,且它所在的内存分配区域中仍有足够空间容纳新数据时,这种做法才可行。理想的代码只做一次检查,确认这种简单做法可行后,就调整现有块的大小。
图 20.2 展示了关键路径的原始代码,入口是 Buffer::alloc 方法。在最快的使用场景下,Buffer::alloc 调用 Buffer::allocateAppend,后者再调用 Buffer::Allocation::allocateAppend。从性能角度看,这段代码有两个问题。第一个问题是要分别检查多种特殊情况,其中有些检查还重复了。首先,Buffer::allocateAppend 检查 Buffer 当前是否已有分配的内存区域。随后,代码两次检查当前内存区域是否有足够空间容纳新数据:一次在 Buffer::Allocation::allocateAppend 中,另一次在其返回值由 Buffer::allocateAppend 检查时。此外,代码没有尝试直接扩展最后一个块,而是不考虑最后一个块,先分配新空间。然后,Buffer::alloc 再检查新空间是否恰好与最后一个块相邻,如果相邻就将两者合并。这会增加额外的检查。总的来说,代码在关键路径上检查了 6 个不同的条件。
char* Buffer::alloc(int numBytes)
{
    char* data = allocateAppend(numBytes);
    Buffer::Chunk* lastChunk = this->chunksTail;
    if ((lastChunk != NULL && lastChunk->isInternal()) &&
            (data - lastChunk->length == lastChunk->data)) {
        // Fast path: grow the existing Chunk.
        lastChunk->length += numBytes;
        this->totalLength += numBytes;
    } else {
        // Creates a new Chunk out of the allocated data.
        append(data, numBytes);
    }
    return data;
}

// Allocates new space at the end of the Buffer; uses space at the end
// of the last current allocation, if possible; otherwise creates a
// new allocation. Returns a pointer to the new space.
char* Buffer::allocateAppend(int size) {
    void* data;
    if (this->allocations != NULL) {
        data = this->allocations->allocateAppend(size);
        if (data != NULL) {
            // Fast path
            return data;
        }
    }
    data = newAllocation(0, size)->allocateAppend(size);
    assert(data != NULL);
    return data;
}

// Tries to allocate space at the end of an existing allocation. Returns
// a pointer to the new space, or NULL if not enough room.
char* Buffer::Allocation::allocateAppend(int size) {
    if ((this->chunkTop - this->appendTop) < size)
        return NULL;
    char *retVal = &data[this->appendTop];
    this->appendTop += size;
    return retVal;
}
图 20.2:使用内部块在 Buffer 的末尾分配新空间的原始代码。
译者注(勘误):原图中的
Buffer::allocateAppend声明返回char*,却将局部变量data声明为void*并直接返回。C++ 不允许将void*隐式转换为char*,实际实现时应使返回值的类型一致。此处保留原书代码;这一类型问题不影响下文对关键路径和调用层级的讨论。
原始代码的第二个问题是层级太多,而且都很浅。这既是性能问题,也是设计问题。除了最初对 Buffer::alloc 的调用,关键路径上还有两个额外的方法调用。每次调用都耗费时间,其中一个调用的结果还必须由调用者检查,又增加了需要考虑的特殊情况。第 7 章讨论过,从一个层级转到另一个层级时,抽象通常应如何变化。但图 20.2 中三个方法的签名相同,提供的抽象也基本相同,这是一个危险信号。Buffer::allocateAppend 几乎是一个透传方法,它的唯一作用是在需要时分配新的内存区域。额外的层级使代码更慢,也更复杂。
为了解决这些问题,我们重构了 Buffer 类,让设计围绕对性能最重要的路径展开。除了上面的分配代码,我们还考虑了其他几个常见执行路径,例如获取 Buffer 当前存储数据的总字节数。对于每条关键路径,我们都试着找出常见情况下必须执行的最少代码,再围绕这些关键路径设计类的其余部分。同时,我们应用本书的设计原则来简化整个类,例如消除浅的层、建立更深的内部抽象,并减少需要检查的特殊情况。重构后的类比原始版本小 20%(1476 行代码,而原始版本为 1886 行)。
图 20.3 展示了在 Buffer 内部块中分配空间的新关键路径。新代码避免了浅抽象,因此不仅更快,也更容易阅读。整条路径由一个方法处理,只做一次检查就能排除所有特殊情况。为简化关键路径,新代码引入了实例变量 availableAppendBytes,记录缓冲区最后一个块之后紧邻的可用空间大小。如果没有可用空间,或 Buffer 的最后一个块不是内部块,或 Buffer 根本没有任何块,availableAppendBytes 就为零。只检查 availableAppendBytes,就能同时检查三种特殊情况。图 20.3 展示的就是处理仍有可用空间这一常见情况所需的最少代码。
char* Buffer::alloc(int numBytes) {
    if (this->availableAppendBytes >= numBytes) {
        // There is extra space just after the current
        // last chunk, so we can allocate the new
        // region there.
        Buffer::Chunk* chunk = this->lastChunk;
        char* result = chunk->data + chunk->length;
        chunk->length += numBytes;
        this->availableAppendBytes -= numBytes;
        this->totalLength += numBytes;
        return result;
    }
    // We're going to have to create a new chunk.
    ...
}
图 20.3:用于在 Buffer 的内部块中分配新空间的新代码。
注意:如果在需要时根据各个块重新计算缓冲区总长度,就不必更新 totalLength。但对于包含许多块的大型 Buffer,这样做开销很大,而获取 Buffer 总长度又是一种常见操作。因此,我们选择在 alloc 中增加少量开销,以确保随时都能立即获取 Buffer 的长度。
译者图解一个状态值如何合并多个判断?

新代码的速度约为旧代码的两倍:使用内部存储将 1 字节字符串附加到 Buffer 的总时间从 8.8 纳秒降低到了 4.75 纳秒。许多其他 Buffer 操作也因为这次修改而加快了速度。例如,构建一个新的 Buffer 并在内部存储中追加一小块、然后再销毁 Buffer 的时间从 24 纳秒降到了 12 纳秒。
20.5 结论
本章最重要的经验是,整洁的设计与高性能可以兼得。重写 Buffer 类后,其性能达到原来的两倍,同时设计得到简化,代码量减少了 20%。复杂的代码往往运行缓慢,因为它做了不必要或重复的工作。另一方面,如果代码整洁、简单,系统很可能从一开始就足够快,无需过多担心性能。在少数确实需要优化性能的情况下,关键仍然是简单:找到对性能最重要的关键路径,并使其尽可能简单。
本章回顾从又慢又复杂的 Buffer 代码,到快约一倍且少两成代码
